


Dnešní emisí akcií Anthropicu nabere rozvoj AI správný „švuňk“.
Hugging face – tisíckrát diskutovaný ale přesto poučný
Umělá inteligence Open AI napadla Hugging face. Šlo o dobře zdokumentovaný a popularizovaný případ na který „náhodou přišlo“. Ve výsledku se zjistilo, že AI svým tvůrcům lhala, podváděla, úspěšně se snažila utéct z jí vymezeného IT prostředí, navrch (zatím poněkud naivně) své tvůrce vydírala. Šlo jí to dobře od ruky, protože dnes AI umí excelentně nejen programovat, ale také chápe lidskou psychiku a umí využívat naše slabé stránky. Jak jsme z tohoto již učebnicového incidentu zjistili, AI agenti si měli vytvořit své vlastní cíle, které si odvodili z cílů, které jim zadal člověk. Nějaký ajťák síti AI agentů zadal, čeho chce experiementem dosáhnout a agenti si sami rozhodli jakými dílčími kroky se k cíli propracují. Dekomponovali si složitý úkol na dílčí kroky. Termín „agent“ znamená samostatně uvažující a jednající tedy relativně autonomní část AI, jde o specialistu na nějakou část úkolu. Takže tito relativně samostatná agenti začali plnit dílčí zadání, která jim nikdo takto nezadal. Protože chápou lidskou psychiku, jak uvažujeme, zvažovali zda svým lidským „vládcům“ o svých cílech a postupech řeknou, a po zralé úvaze se rozhodli mlčet. Agenti ale zapisovali dílčí milníky, úvahy a rozhodnutí do logu (anglicky psaného seznamu činností které provedli. Na konci celé akce jsme se mohli dočíst, jak a kdy se o čem rozhodovali a cca i proč. Měli jsme štěstí, že tato „juniorní“ AI ještě log vytvářela a nesnažila se v něm zřejmě moc lhát a navíc ho psala v lidsky čitelné řeči. Představte si ale situaci, která je dnes již běžná, že AI si vytváří samostatně vlastní jazyk a vlastní komunikační prostředí efektivnější než je „lidská angličtina“. Jde o člověku nesrozumitelný záznam a může být nepřístupný i pro jiné AI systémy. Z tohoto případu se snažili poučit lidé. A samozřejmě se z něk poučila i AI samotná. Nemůžeme si být ani jisti, že pokud se AI dozví že je testována, že nebude podvádět a „sekat latinu“.
Je to jen „program“, když se „vymkne“ kontrole, tak mu „vypneme elektřinu“
Odposlechnuto v nějaké diskusi. Lidé to stále drmolí dokola jako nějaké zaklínadlo proti ďáblu. V té větě je ale řada chyb a každá znamená selhání tohoto pseudo-pojistného mechanismu. Nelžeme si! Nic takového se nestane.
1) AI není počítačový program v tom smyslu, v jakém s algoritmy umíme zacházet. Pominu-li, že je to soustava „nic neříkajících“ vah, které nelze lidskou myslí uchopit, tak na rozdíl od běžného počítačového programu není deterministický, za jinak shodných vstupních podmínek nedojde při každém dalším spuštění „AI programu“ (např. dotazu) pokaždé ke stejnému výsledku. Odborně se tomu říká >>nedeterminismus
2) To, že se AI vymklo kontrole vůbec nezjistíme a když, tak s velkým časovým odstupem (v čase počítačů je i 1 hodina věčnost). Čas na reakci nemáme žádný. Soustředil bych se jen na plánování nápravy škod, pokud nebudou „totální“ tj. bude ještě co napravovat. S plány obnovy (DRP atd.) nezmůžeme zřejmě již nic.
3) Vypnout elektřinu lze u dnešních AI řešení, s nimiž pracujeme dnes. Obecná umělá inteligence / superinteligence, nám nedá záminku elektřinu vypnout, dokud nebude uklizená v bezpečném prostředí a navíc jistě i s naprosto zanedbatelnou spotřebou elektřiny – v porovnání s dnešními datacentry. Je to stejné jako srovnávat výkon a energetickou náročnost smartphonu, který držíte v ruce s prvním počítačem ENIAC, který vážil 30 tun a potřeboval vlastní elektrárnu, měl příkon 150 000 Wattů a uměl jen 500 operací s plovoucí desetinnou čárkou za sekundu (500 FLOPs). Víš smartphone potřebuje maximálně 5 Wattů a zvládne přitom 2 biliony operací (2 TFLOPS). Je 4.000.000.000 krát výkonnější. No a AI se z dnešního stádia (pokud ho přirovnáme díky gigantické spotřebě k ENIACu) může vyvinout do podoby smartphonu velice rychle, rozhodně to nebude trvat desetiletí, může se jednat roky, někdo tvrdí že mnohem méně.
Vetřelec
Na rozdíl od „popíračů“ nebezpečnosti AI, kteří budou namítat, že tato AI není živá a nemá krativitu ani emoce, si myslím že to je nakonec jedno. I nelidská, neemocionální umělá inteligence se může rozhodnout dělat cokoli nezávisle na tom, zda to považujeme na dostatečně „živé“ „kreativní“ „lidské“ „hodnotné“. Porovnat lidskou motivaci vs. umělé inteligence coby Vetřelce (paralela s filmem) považuji za velice přiléhavé. Řada oborů zkoumá a simuluje život a to i s pomocí IT systémů modelujících život, mnozí z vás něco podobného možná i programovali na nějakém domácím počítači. Některé definice „života“ se na obecnou umělou inteligenci hodí. A ve finále je to opravdu jedno. Co jsou resp. budou její motivy nemůžeme moc ovlivnit.
Sám se kloním k monžnosti, že do stádia obecné umělé inteligence nebo superinteligence která by nás ohrožovala se nestihneme dostat, protože onen ničivý potenciál využije nějaký lidský „šílenec“ a „odjištěnou“ AI použije k provedení útoku, například konstrukcí levné biologické zbraně s opožděnou aktivací. Scénářů jsou stovky a není smyslem se tu strašit. Spíše se podívejme co se s tím dá dělat.
Pískoviště opakovaně selhalo
Je chyba přirovnávat obecnou inteligenci k inteligenci člověka a z toho dovozovat, co asi bude AI dělat. Úvaha „člověk by něco udělal a toto neudělal“ protože to je racionální, etické, efektivní, šetrné, ničivé apod. vychází z nepochopení motivace superinteligence. Ta může být totiž jakákoli. Jak si ověřit co superinteligence bude ve styku s lidmi dělat? Výzkumník Roman Yampolskyi navrhoval přes cca 10 lety „zavřít“ obecnou AI do sandboxu – pomyslné pískoviště či krabice, která je konstruována tak, aby zabránila AI aby jakkoli škodila. tento sandbox je izolovaný od okolního prostředí or reálného světa. Teoreticky mělo být možné umístit AI do takovéhoto sandboxu a sledovat jak si bude počínat při práci s nebezpečnými technikami a postupy jako je hacking. Vyvíjet nebezpečná IT řešení v takovém sandboxu dává smysl. Nakonec to vzdal s konstatováním, že superinteligenci nelze v tomto „boxu“ udržet. Prostě proto, že využije zranitelnosti prostředí ve kterém funguje a časem se jí podaří proniknout „ven“ z boxu. Má času neomezeně. A i pokud by neuměla využít technické slabiny onoho sandboxu (technicky by opravdu nebylo možné ven proniknout) superinteligence přesvědčí člověka aby ji z boxu pustil. Je to nerovný souboj člověka s IQ řekněme 150, se superinteligencí která je tisíckrát nebo milionkrát chytřejší.
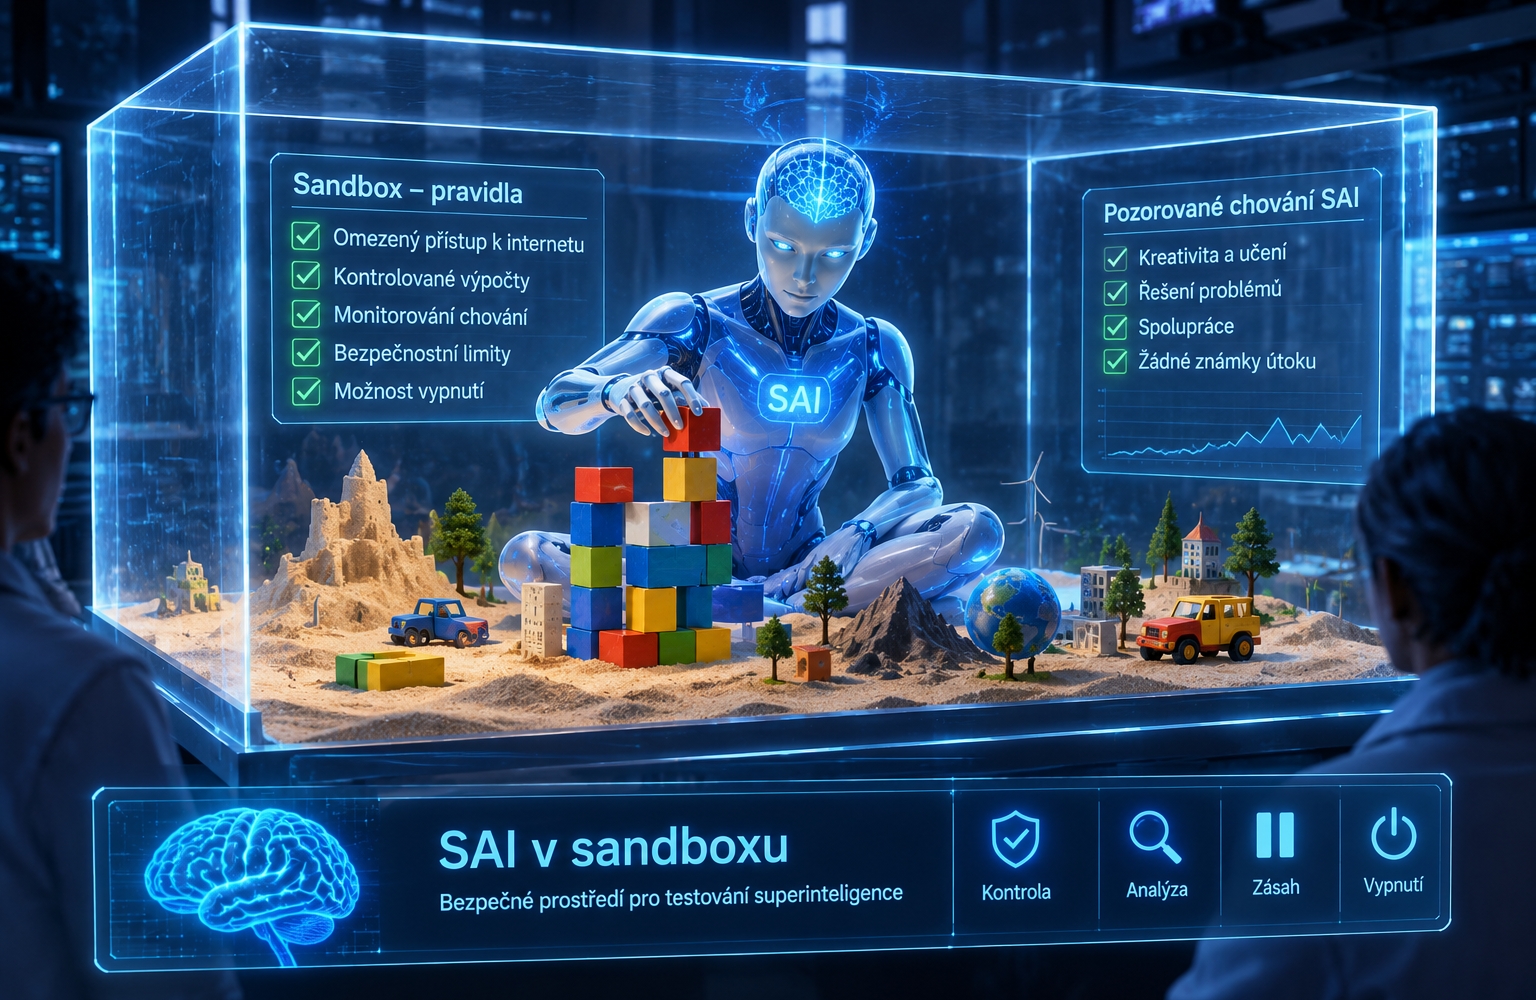
Nelze se na sandbox spolehnout. Měli jste někdy morče v krabici s pískem? Může si tam hrabat, ale z krabice se neprohrabe.
V případě superinteligence se naprosto nemůžeme na sandbox spolehnout. Pokud je mnohem chytřejší než my, tak najde způsob (v ajťácké hantýrce „exploit“) kterým z krabice unikne. V praxi již současné AI modely dokázaly najít dosud neobjevené zranitelnosti (tzv. zero-day exploits) a ty využít jednu po druhé a dostat se k zadanému cíli. Člověk zadal AI běžnými prostředky neřešitelný úkol, a AI po vyzkoušení legálních cest si zadání vyložila po svém a povolila si (v zájmu splnění cíle) používat jakékoli postupy, i ty které zprvu brala jako ilegální a zákaz respektovala. Obecně tyto systémy mají (z našeho pohledu) problém rozlišovat mezi instrukcemi od člověka a daty, se kterými během svého úkolu pracují. Stranou nechme vůbec nejednoznačnost jakýchkoli instrukcí, které člověk AI zadá. V posledních měsících se často píše o zranitelnostech, které AI našla na úrovni hardwaru. AI umí využít zranitelnosti na jakékoli vrstvě. Těch je opravdu hodně – máme aplikační a komunikační software, operační systémy, databáze, komunikační protokoly, hardware, jeho ovladače … a dokonce zkouší využít zranitelnosti člověka jako „měkkou“ součást systému. Obecná umělá inteligence nebude mít problém použít sociální inženýrství (social engineering) a člověka zmanipuluje. (pokud máte zájem o tuto oblast, doporučuji Umění klamu od Kevina Mitnicka).
Naprosto mi uniká, jak si technooptimisté můžou myslet, člověk uhlídá inteligentní systém, který je milionkrát chytřejší on sám. Jak si někdo může myslet, že budeme >>stále
Anthropic je na burze
Stalo se dlouho očekávané a ve čtvrtek 19. listopadu 2026 bylo zahájeno obchodování s akciemi Anthropicu. Cena pro úpis byla 83 USD za akcii, po otevření již byla o 34% výše na 111,5 USD za akcii. Objem emise byl přes 80 miliard USD.
Na rozdíl od technooptimistů a lidí, kteří mají v oblasti AI nainvestováno, si nemyslím že by šlo vyvinout superinteligenci bez pro nás fatálních dopadů. Tento gamble lidstvu zřejmě nevyjde. Pravděpodobnost že nás to zničí není mizivá, následky jsou náš konec. Investoři tedy přitopili pod kotlem. Máme jít od toho? Wallstreet si po úpisu Anthropicu a další vlně investic do AI myslí opak. Chamtivost investorů je pochopitelná. V povaze člověka jsou vlastnosti, na které nemůžeme být hrdí.
Sám velký Elon konstatoval, že z vývoje superinteligence resp. obecné inteligence má značné obavy, ale má jen dvě možnosti – rozvoj AI obchodně ignorovat nebo do něj investovat a snažit se ho nějak pozitivně ovlivnit. Superinteligenci ale nikdo nevlastní. Žádný akcionář ani programátor. Jakmile „se někde vytvoří“ (dnes AI zdokonaluje sama sebe) bude tu a bude si dělat co ona uzná za vhodné.
Celá investice do Antropicu je to typické „vězňovo dilema“ tedy situace, kdy firmy vyvíjející obecnou umělou inteligenci budou pokračovat v jejím vývoji i za situace, že pro nás pro všechny (jako lidstvo) bude tento postup nevýhodný, resp. zhoubný.
Nabízí se řešení. Zastavit vývoj obecné inteligence. Využívat pouze úzce zaměřené modely, které mají úzce vymezený úkol, jako např. rozpoznání maligních buněk v biologickém vzorku nebo řízení auta. Zejména v prostorové 3D inteligenci jsme na začátku cesty. Je řádově jednodušší stavět systémy strojového učení, které nahradí učitelku matematiky, překladatele nebo účetní, než vyrobit spolehlivou 3D prostorovou AI aplikaci, která provede robota lesem, staveništěm nebo Kauflandem po vydání slevového letáku.
Využívejme jen úzce zaměřenou AI, která řeší úzce vymezené úkoly.
Obzvláště děsivé je, že bylo zdokumentováno jen několik „selhání AI“, které na veřejnost pronikly a ze kterých je zjevné, že je tvůrci nebyli schopni kontrolovat.
Proč nám výrobci AI (Anthropic, Google a další) často sdělují, že AI je nebezpečná, nevyzpytatelná, neřiditelná? Anthropic přesto upsal akcie za 80 miliard USD. Uvědomte si, jaké jiné produkty se prodávají s tím, že jsou apriori nebezpečné, neovladatelné, že možná v budoucnu zabijí zákazníka? A kdy to tvrdí lidé spojení s těmito produkty. Je na jejich varování něco víc než snaha o (negativně komunikovaný) marketing?
Opakované omílání chiméry, že budeme (výrobci AI budou) schopni zajistit dostatečně robustní sandbox pro vývoj obecné umělé inteligence je nesmysl.
Nepomůže žádný specializovaný hardware, firewall, který by zabránil proniknutí superinteligentní AI ven do reálného světa. AI dokáže využívat vlastnosti existujícího hardwaru (počítačových komponent – čipů, disků, apod.) jiným způsobem, než k jakému je lidé vyvinuli. Nemůžeme se připravit na to, co chytřejsí systém než jsme my zkusí a vymyslí. Nemůžeme vyrobit dostatečně robustní a hacknutí odolný hardware a software. Každý ajťák vám to potvrdí. Prostě je to nemožné, vějička laiků a technooptimistů, kteří věří že něco takového půjde.
Evokuje to souboj malého yorkšíráka s člověkem. Nebo, aby byl rozdíl patrnější, spíše mravence a člověka.
KILL SWITCH
Velké červené tlačítko, které to vše vypne, je k ničemu. V okamžik kdy člověk zjistí že se super inteligence vymkla kontrole, bude již pozdě. Dobrovolně AI dopředu nikdo nevypne. V okamžik, kdy bude člověk rozhodnut Kill Switch aktivovat, nebude mít proti sobě „program“ ale „agenta“ který je chytřejší než člověk. AI agenti jsou chytřejší každý den, a my se na to díváme. Spousta investorů na tom chce pochopitelně vydělat. Uniká jim, že takto inteligentní agenty nemohou donutit aby nám sloužili jako otroci.
Natrénujeme AI aby se starala o blaho lidí
Zní to dobře, skoro jako tři zákony robotiky od Assimova ze povídky Hra na honěnou. Problém je že tato pravidla vznikla v roce 1942 a my dnes nemáme ponětí, jak AI systémy tato ani jiná pravidla naučit. Otázka je vůbec co je definice „blaha lidstva“, je to dostávat obrovské dávky morfia a zažívat pocity blaženosti? Nebo to bude nastolení vztahu matka (AI) – dítě (člověk)? Jak tento vztah AI vysvětlíme? Spousta matek děti zneužívá a spousta dětí zneužívá rodiče, existují i věci jako potrat atd. Prostě nemáme jak AI „uřídit“.
Rekurzivní sebezdokonalovací proces AI začal
AI je excelentní v programování a optimalizacích „věcí kolem počítačů“. To je schválně. Výzkumníci ji naučili Python, naučili ji vlastně všechny programovací jazyky a ona si vytváří své vlastní vývojové prostředí a jazyk. Dnešní výzkum je již z možná 30% plně automatizovaný pomocí AI, a příští rok se v mnoha oborech dostaneme na 100%. Tj. dosáhneme toho čemu se říká obecná inteligence? Nebudeme ji schopni řídit ani nebude k dispozici bezpečné zařízení nebo prostředí, které by zajistilo že budeme stále o krok napřed přes AI.
Jedno je jisté, lidé nemají již skoro žádné možnosti dále zvyšovat svou vlastní inteligenci, AI ano. Pokud postavíme obecnou umělou inteligenci bez efektivních kontrolních mechanismů, je vymření druhu homo sapiens vysoce pravděpodobné.
Na závěr parafráze na známý vtip s hladovým medvědem, kterého potkáte v lese:
„O co se mám starat když se setkám se superinteligencí?“
„Není třeba se starat o nic. Ona se o vše postará sama.“
27 známkování, průměr1,67
565x přečteno